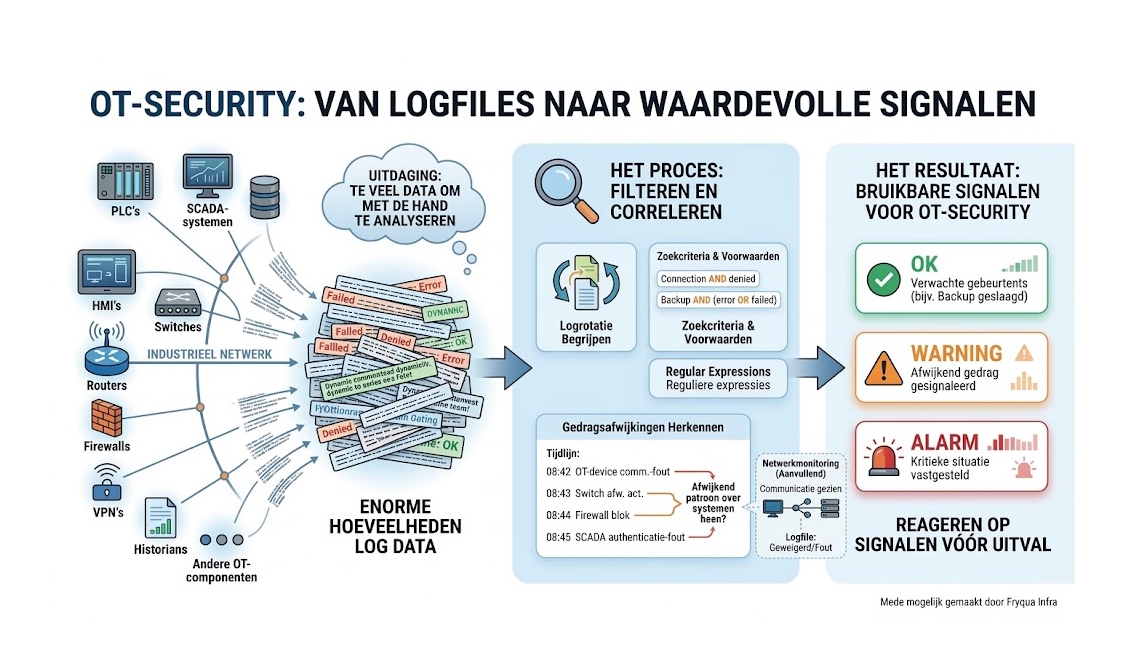
Een industrieel netwerk kan tegenwoordig enorme hoeveelheden informatie produceren. PLC’s, SCADA-systemen, HMI’s, switches, routers, firewalls, VPN’s, historians en andere OT-componenten schrijven continu informatie weg naar logfiles. Dat is op zichzelf goed nieuws, want iedere logregel vertelt een stukje van de werkelijkheid.
Het probleem ontstaat wanneer er zoveel informatie wordt geproduceerd dat niemand meer in staat is om er daadwerkelijk naar te kijken. En juist daar kan een interessante blinde vlek in OT-security ontstaan. Je hoeft niet iedere logregel te lezen. Je hoeft ook niet ieder netwerkpakket handmatig te analyseren. Maar je moet wel in staat zijn om relevante signalen uit je OT-omgeving te halen.
Want een systeem hoeft niet eerst uit te vallen voordat er iets aan de hand is. Soms vertelt het systeem het al. Je moet alleen wel luisteren.
OT draait door, terwijl er ondertussen van alles gebeurt
Een belangrijk verschil tussen traditionele IT en OT is dat beschikbaarheid vaak extreem belangrijk is. Een productielijn kan niet zomaar worden uitgezet om even een beveiligingsupdate uit te voeren. Een PLC vervang je niet omdat er een nieuwe softwareversie beschikbaar is. En sommige industriële systemen draaien jarenlang met dezelfde configuratie. Dat betekent ook dat je bij OT-security niet uitsluitend kunt vertrouwen op traditionele beveiligingsmaatregelen.
Je wilt vooral weten wat er daadwerkelijk gebeurt op je OT-netwerk? Daarbij kijken organisaties steeds vaker naar netwerkverkeer en gedragsafwijkingen. Maar er is nog een andere informatiebron die vaak over het hoofd wordt gezien: de logfiles die de systemen zelf produceren.
Een logfile is eigenlijk een sensor
Een logfile lijkt op het eerste gezicht misschien gewoon een tekstbestand. Maar technisch gezien is het een verzameling observaties van wat een systeem heeft meegemaakt. Een firewall kan bijvoorbeeld vastleggen dat een verbinding is geweigerd. Een switch kan melden dat een netwerkverbinding is weggevallen. Een SCADA-systeem kan een communicatieprobleem registreren. Een HMI kan een authenticatiefout melden. Een server kan melden dat een service onverwacht is gestopt. Een PLC-gerelateerd systeem kan een communicatie- of devicefout registreren.
Iedere afzonderlijke melding hoeft niets bijzonders te betekenen. Maar meerdere meldingen bij elkaar kunnen een heel ander beeld geven. Van duizenden regels naar relevante signalen gaan is dus een uitdaging.
Stel dat een OT-firewall iedere minuut logt welke verbindingen worden toegestaan en geweigerd. Dat kan al snel duizenden regels per dag opleveren. Daar komt vervolgens de logging van switches, servers, SCADA-systemen en andere componenten nog bij. Het is niet realistisch om een beheerder iedere logregel te laten beoordelen.
Je hebt daarom een mechanisme nodig dat om onderscheid te maken tussen: normale informatie en informatie die aandacht verdient. Dat hoeft niet altijd ingewikkeld te zijn.
Logrotatie maakt monitoring niet eenvoudiger
OT-omgevingen hebben bovendien te maken met verschillende soorten logfiles. Sommige logfiles blijven groeien, andere worden periodiek overschreven en weer andere roteren automatisch zodra ze een bepaalde grootte bereiken.
Een monitoringoplossing moet daarom niet alleen kunnen zoeken naar tekst, maar ook begrijpen hoe met die bestanden wordt omgegaan. Bij Fryqua Infra wordt bijvoorbeeld automatisch herkend wanneer een groeiende logfile kleiner wordt. Dat kan betekenen dat het logfile is geroteerd en dat een nieuw bestand is aangemaakt.
De monitoring kan vervolgens opnieuw vanaf het begin van het nieuwe bestand beginnen. Dat klinkt misschien als een technisch detail. In een productieomgeving zijn juist dit soort details belangrijk. Een eenvoudige combinatie kan al waardevol zijn: “connection AND denied”. Maar je kunt ook specifieker zoeken: “backup AND (error OR failed)”
Of zoeken naar een specifieke foutmelding, gebeurtenis of patroon. Het voordeel daarvan is dat je niet hoeft te wachten totdat een systeem daadwerkelijk uitvalt. Je kunt reageren op het signaal dat eraan voorafgaat.
Niet iedere melding hoeft een alarm te zijn
Een ander probleem met logmonitoring is de zogenaamde notificatiestorm. Stel dat een systeem iedere minuut schrijft: “Could not connect to server” Als je iedere match direct als alarm verstuurt, heeft de beheerder binnen een uur tientallen of honderden meldingen. Dat helpt niemand. Daarom moet je ook kunnen bepalen hoe met herhaalde meldingen wordt omgegaan. Bij Fryqua Infra kan bijvoorbeeld worden ingesteld dat een identieke melding gedurende een bepaalde periode wordt onderdrukt. Je krijgt dan wel het relevante signaal, maar niet iedere minuut dezelfde melding.
Signaleren zonder te overspoelen.
Niet alleen fouten zijn interessant
Een belangrijk punt bij logmonitoring is dat je niet alleen naar het woord “error” hoeft te zoeken. Ook een succesvolle gebeurtenis kan relevant zijn.
Bijvoorbeeld: “Backup completed successful” kan als een OK-melding worden gebruikt. Dat lijkt misschien vreemd wanneer je vanuit security denkt. Maar het geeft juist de mogelijkheid om monitoring breder te gebruiken:
- OK: Wanneer een verwachte gebeurtenis plaatsvindt
- Warning: Wanneer er een afwijking optreedt
- Alarm: Wanneer een kritieke situatie wordt vastgesteld
En dan wordt OT bijzonder interessant
In een kantooromgeving kan een tijdelijk netwerkprobleem vervelend zijn. In een industriële omgeving kan hetzelfde type gebeurtenis onderdeel zijn van een veel groter probleem. Denk bijvoorbeeld aan een productielijn waarbij verschillende systemen met elkaar communiceren.
Een enkele communicatiefout hoeft niets te betekenen. Maar stel dat je achter elkaar ziet: 08:42 – een OT-device meldt een communicatiefout 08:43 – een switch registreert afwijkende netwerkactiviteit 08:44 – een firewall blokkeert een verbinding 08:45 – een SCADA-systeem meldt een authenticatiefout
Dan wordt het interessant. Niet omdat één van deze meldingen noodzakelijkerwijs een cyberaanval betekent. Maar omdat de combinatie van gebeurtenissen aanleiding geeft om verder te kijken. En dat is precies waarom logdata interessant wordt binnen OT-security. Daarmee wordt logfile monitoring niet alleen een manier om fouten te vinden. Het wordt een manier om te controleren of systemen zich gedragen zoals verwacht.
Logfiles naast netwerkmonitoring
Netwerkmonitoring en logfilemonitoring hoeven elkaar niet te vervangen. Ze kunnen elkaar juist aanvullen. Netwerkmonitoring kan bijvoorbeeld laten zien:
Er vindt communicatie plaats tussen deze twee systemen.
Een logfile kan vervolgens laten zien:
Het systeem heeft deze communicatie geweigerd.
Of:
De applicatie meldt een fout bij deze verbinding.
Je krijgt daarmee verschillende perspectieven op dezelfde omgeving. En hoe meer van die signalen je kunt combineren, hoe beter je kunt bepalen wat normaal is en wat afwijkend lijkt.
Fryqua Infra: niet méér logdata, maar bruikbare signalen
Daar ligt ook de rol van Fryqua Infra. Het doel is niet om nog een dashboard toe te voegen waarop een beheerder duizenden logregels kan bekijken. Het doel is juist om uit bestaande informatie de gebeurtenissen te halen die relevant zijn. Met labels kunnen zoekcriteria worden vastgelegd.
Met AND, OR en NOT kunnen voorwaarden worden gecombineerd. Wanneer nodig kunnen eenvoudige regular expressions worden gebruikt om patronen of waarden te herkennen. En met notificatieniveaus kan worden bepaald of een gebeurtenis als OK, Warning of Alarm moet worden behandeld.
Daarmee kun je heel gericht bepalen: Wat wil ik weten? in plaats van: Wat staat er allemaal in mijn logfile?
De volgende stap: patronen herkennen over verschillende systemen heen
De echte waarde ontstaat wanneer logdata niet als een verzameling losse gebeurtenissen wordt bekeken. Want in een OT-omgeving zijn systemen met elkaar verbonden. Een gebeurtenis op een firewall kan verband houden met een switch. Een switchmelding kan verband houden met een PLC-communicatieprobleem.
Een SCADA-melding kan vervolgens hetzelfde incident vanuit een heel ander perspectief laten zien. Dan wordt de interessante vraag niet meer: “Welke logregel bevat het woord error”? maar:
“Welke combinatie van gebeurtenissen wijkt af van wat we normaal in deze omgeving zien?”
Daar begint logfilemonitoring over te gaan in gedragsmonitoring.